Бүх нийтлэлүүд
2026.10.034 min read#хиймэлоюунбаөгөгдлийншинжлэхухаан
Attention Mechanism
У.Дэлгэрмөрөн
Багш

У.Дэлгэрмөрөн
Багш
Attention mechanism нь орчин үеийн хиймэл оюун ухаан, ялангуяа Natural Language Processing буюу NLP салбарын хамгийн чухал ойлголтуудын нэг юм. Хүн аливаа өгүүлбэрийг уншихдаа бүх үгийг ижил хэмжээгээр анхаардаггүй. Жишээлбэл, “The student studied hard because he wanted to pass the exam” гэсэн өгүүлбэрийг унших үед “he” гэдэг үг хэнийг зааж байгааг ойлгохын тулд бид “student” гэдэг үг рүү илүү анхаарна. Neural network-д ч мөн адил урт өгүүлбэрийн бүх мэдээллийг ижил ач холбогдолтой гэж үзэхийн оронд тухайн мөчид хэрэгтэй мэдээлэлд илүү их жин өгөх шаардлага гардаг. Үүнийг Attention mechanism шийддэг. Өөрөөр хэлбэл, Attention нь model-д “Одоогийн энэ үгийг ойлгохын тулд өмнөх болон бусад үгсээс алийг нь илүү анхаарах хэрэгтэй вэ?” гэдгийг тооцоолох боломж олгодог. Attention бий болохоос өмнө NLP-д RNN болон LSTM зэрэг architecture өргөн ашиглагддаг байсан. Гэвч урт өгүүлбэр боловсруулах үед эхэнд байсан мэдээлэл алдагдах, дарааллыг нэг нэгээр нь боловсруулах шаардлагатай учраас сургалт удаан байх зэрэг асуудал гардаг байв. Attention mechanism нь тухайн үг болон бусад бүх үгийн хоорондын хамаарлыг шууд тооцоолсноор энэ асуудлыг тодорхой хэмжээнд шийдсэн бөгөөд Transformer architecture үүсэх үндсэн санаа болсон.
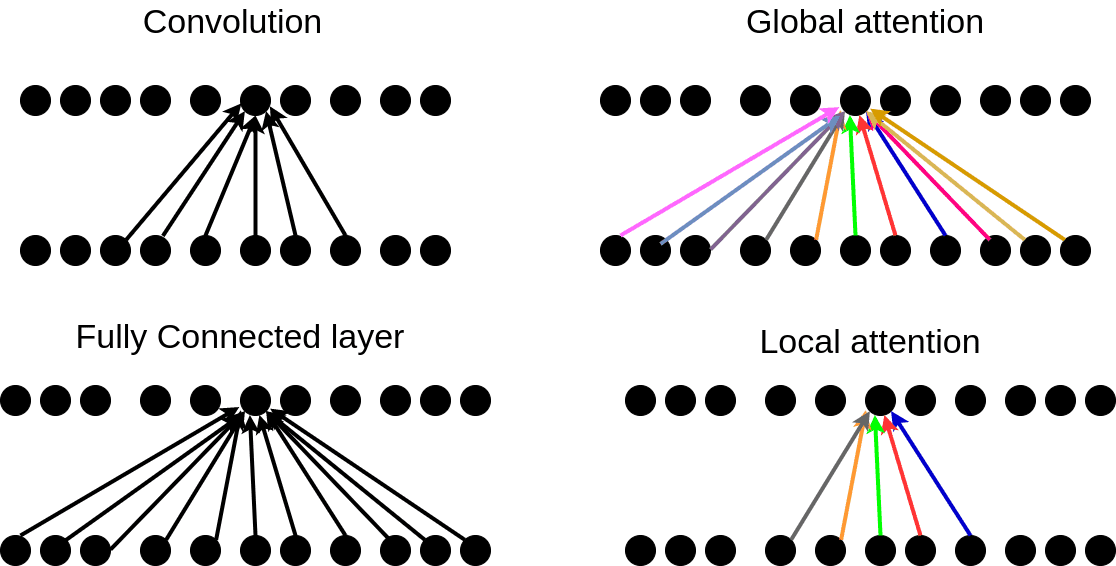
Attention-ийн ажиллагааг ойлгохын тулд Query, Key, Value гэсэн гурван үндсэн ойлголтыг мэдэх хэрэгтэй. Эдгээрийг мэдээлэл хайж байгаа системтэй зүйрлэж болно. Query нь “Би ямар мэдээлэл хайж байна вэ?”, Key нь “Надад ямар мэдээлэл байна вэ?”, харин Value нь “Тэр мэдээллийн жинхэнэ агуулга юу вэ?” гэдгийг илэрхийлдэг. Жишээлбэл, “The cat sat on the mat because it was tired” гэсэн өгүүлбэр дэх “it” гэдэг үгийг model боловсруулж байна гэж бодъё. Энэ үед “it”-ийн vector нь Query болж, өгүүлбэрийн бусад үг бүр Key болон Value vector-той байна. Model Query болон Key бүрийн хооронд хэр төстэй байгааг dot product ашиглан тооцдог. Хэрэв “it” болон “cat” хоорондын хамаарал өндөр байвал “cat” илүү өндөр attention score авна. Дараа нь эдгээр score-ийг тогтвортой болгохын тулд ихэвчлэн √dₖ утгаар хувааж, Softmax function-д оруулна. Softmax-ын үр дүнд бүх attention weight-ийн нийлбэр 1 болно. Жишээлбэл, “cat” 0.65, “mat” 0.10, “tired” 0.20, бусад үг 0.05 гэсэн жинтэй байж болно. Эцэст нь эдгээр weight-ийг Value vector-уудтай үржүүлж нийлүүлснээр тухайн үгийн шинэ context-aware representation үүсдэг. Үүнийг томъёогоор Attention(Q,K,V) = softmax(QKᵀ / √dₖ)V гэж илэрхийлдэг. Ингэснээр model зөвхөн тухайн үгийн өөрийн утгыг бус, өгүүлбэр доторх бусад үгтэй ямар харилцаатай байгааг хамтад нь ойлгох боломжтой болдог.
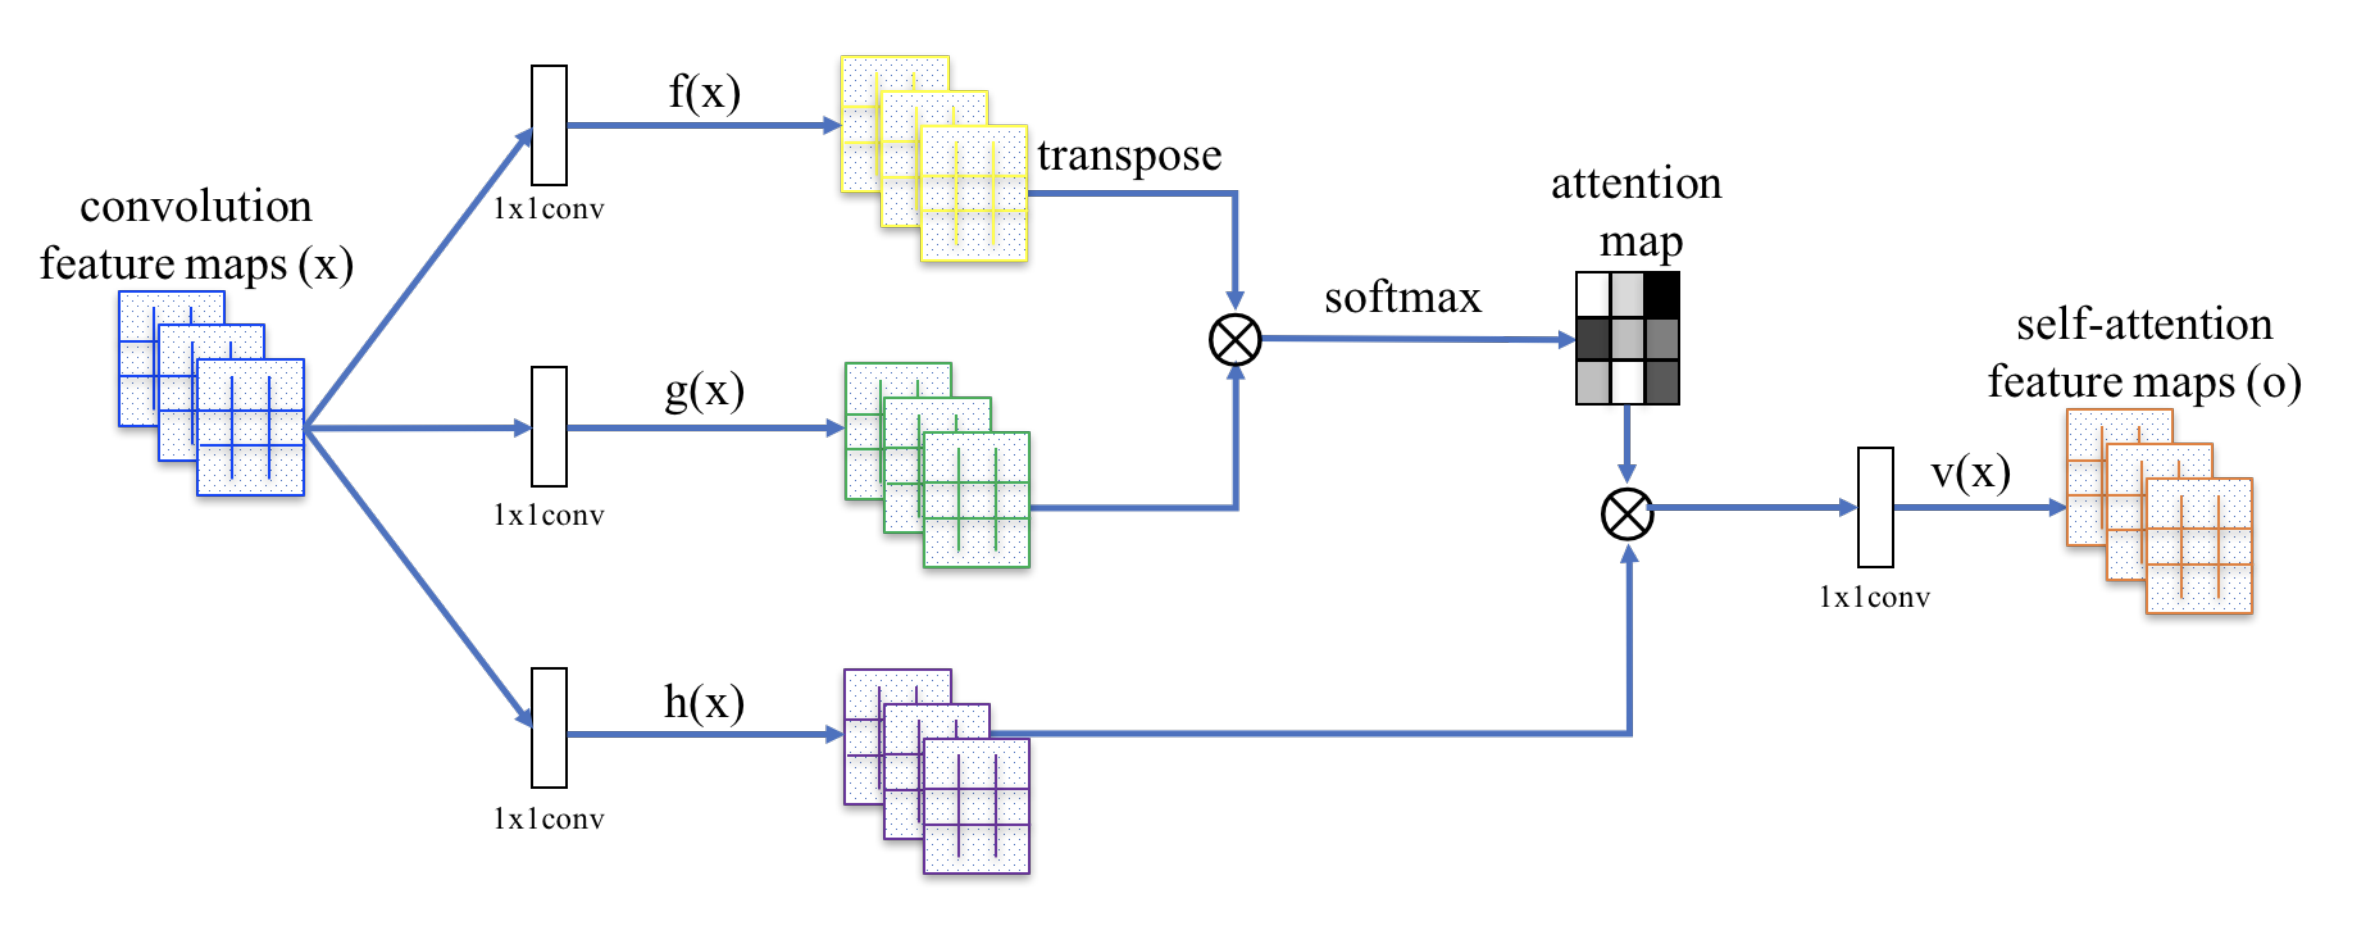
Transformer architecture-д ашиглагддаг хамгийн чухал Attention төрөл бол Self-Attention юм. Self-Attention гэдэг нь нэг өгүүлбэр доторх үгс хоорондоо харилцан анхаарал хандуулахыг хэлнэ. Жишээлбэл, “The animal did not cross the street because it was too tired” гэсэн өгүүлбэрийн “it” гэдэг үг “street”-ийг бус “animal”-ийг зааж байгааг model Self-Attention ашиглан ойлгоно. Гэхдээ нэг л төрлийн хамаарлыг сурах нь хангалтгүй байдаг. Тиймээс Transformer нь Multi-Head Attention ашигладаг. Энэ нь Attention-ийг хэд хэдэн хэсэг буюу head-аар зэрэг тооцдог гэсэн үг. Нэг attention head нь өгүүлбэрийн grammatical relationship-д анхаарч байхад өөр нэг head нь semantic meaning, өөр нэг нь урт хугацааны хамаарлыг ажиглаж болно. Жишээлбэл, нэг head subject болон verb хоорондын холбоог, нөгөө нь pronoun болон түүний зааж буй noun-ыг, өөр нэг нь өгүүлбэрийн ерөнхий утгын хамаарлыг сурах боломжтой. Эдгээр head-ийн гаргалтыг дараа нь нийлүүлж final representation үүсгэнэ. Transformer-ийн том давуу тал нь RNN шиг үг бүрийг заавал дарааллаар боловсруулах шаардлагагүй явдал юм. Self-Attention ашигласнаар өгүүлбэрийн олон token-ийг зэрэг буюу parallel хэлбэрээр боловсруулах боломжтой. Энэ нь GPU дээр сургалтыг маш хурдан болгосон бөгөөд маш том dataset, олон тэрбум parameter-тай language model-уудыг сургах боломжийг нээсэн.
Transformer architecture-д ашиглагддаг хамгийн чухал Attention төрөл бол Self-Attention юм. Self-Attention гэдэг нь нэг өгүүлбэр доторх үгс хоорондоо харилцан анхаарал хандуулахыг хэлнэ. Жишээлбэл, “The animal did not cross the street because it was too tired” гэсэн өгүүлбэрийн “it” гэдэг үг “street”-ийг бус “animal”-ийг зааж байгааг model Self-Attention ашиглан ойлгоно. Гэхдээ нэг л төрлийн хамаарлыг сурах нь хангалтгүй байдаг. Тиймээс Transformer нь Multi-Head Attention ашигладаг. Энэ нь Attention-ийг хэд хэдэн хэсэг буюу head-аар зэрэг тооцдог гэсэн үг. Нэг attention head нь өгүүлбэрийн grammatical relationship-д анхаарч байхад өөр нэг head нь semantic meaning, өөр нэг нь урт хугацааны хамаарлыг ажиглаж болно. Жишээлбэл, нэг head subject болон verb хоорондын холбоог, нөгөө нь pronoun болон түүний зааж буй noun-ыг, өөр нэг нь өгүүлбэрийн ерөнхий утгын хамаарлыг сурах боломжтой. Эдгээр head-ийн гаргалтыг дараа нь нийлүүлж final representation үүсгэнэ. Transformer-ийн том давуу тал нь RNN шиг үг бүрийг заавал дарааллаар боловсруулах шаардлагагүй явдал юм. Self-Attention ашигласнаар өгүүлбэрийн олон token-ийг зэрэг буюу parallel хэлбэрээр боловсруулах боломжтой. Энэ нь GPU дээр сургалтыг маш хурдан болгосон бөгөөд маш том dataset, олон тэрбум parameter-тай language model-уудыг сургах боломжийг нээсэн.