Бүх нийтлэлүүд
2026.10.022 min read#програмчлалбакод
Секунд тутамд сая сая утга хүлээж авах нь
О.Дэлгэрмаа
Багш

О.Дэлгэрмаа
Багш
Өнөөдөр бидний эргэн тойрон дахь ухаалаг төхөөрөмжүүд (IoT), үйлдвэрлэлийн датчикууд, машины лог файлууд, тэр ч байтугай фитнесс цаг секунд тутамд тасралтгүй өгөгдөл илгээж байна. Гэхдээ энэ олон тэрбум утгыг уламжлалт харилцаат өгөгдлийн сангууд (Relational DB - MySQL, PostgreSQL гэх мэт) яагаад дийлэхгүй болсон бэ?
Уламжлалт харилцаат өгөгдлийн сангууд (RDBMS - MySQL, PostgreSQL гэх мэт) өгөгдлийг хадгалахдаа голдуу B-Tree индекс ашигладаг. Энэ нь өгөгдлийг дур зоргоороо шинэчлэх (UPDATE), устгах (DELETE) эсвэл хайхад маш сайн боловч секундэд хэдэн зуун мянгаараа тасралтгүй урсан орж ирэх бичих үйлдлийг (High-throughput writes) дийлэхгүй гацдаг.
Индексийн ачаалал: Шинэ утга бүр ирэхэд B-Tree модыг шинэчлэх шаардлагатай болж дискний оролт/гаралт (I/O) эрс нэмэгддэг.
Цаг хугацааны давхардал: IoT төхөөрөмжүүд бүгд л timestamp, device_id, temperature гэсэн бүтцээр утга илгээдэг тул диск дээр асар их зай үр ашиггүй зарцуулагддаг.
Харин цаг хугацааны өгөгдлийн сангууд (TSDB) нь Append-only буюу зөвхөн араас нь нэмж бичих зарчмаар ажилладаг бөгөөд өгөгдлийг цаг хугацааны хуваалтаар (Time-based partitioning / Chunks) жижиг хэсгүүдэд хувааж санах ойд эсвэл дискэнд маш оновчтой байршуулдаг.
TSDB-ийн хамгийн хүчирхэг зэвсэг бол шахалт юм. Жишээ нь, TimescaleDB эсвэл InfluxDB нь дараах алгоритмуудыг хослуулан ашигладаг:
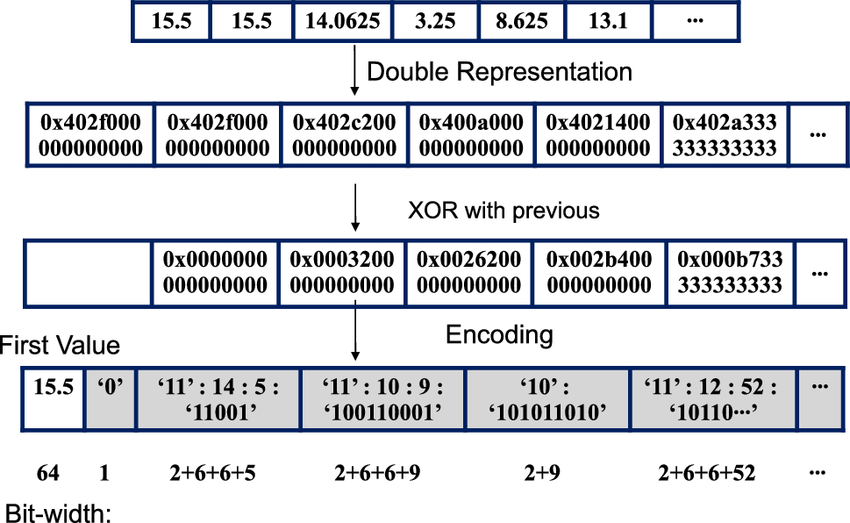
1. Gorilla Compression (Delta-of-Delta): Цаг хугацааны тэмдэглэгээ (timestamps) хоорондын зай ихэнхдээ тогтмол байдаг (жишээ нь яг 1 секунд тутамд). Тиймээс бүхэл бүтэн timestamp бичихийн оронд өмнөх утгаас хэр зөрүүтэй байгааг (delta) л маш цөөн биитээр тэмдэглэдэг.
2. XOR Encoding: Тоон утгуудын (Float values) хувьд дараалсан утгууд хоорондоо төстэй байдаг тул XOR үйлдэл ашиглан тэгийг түлхүүр болгон шахдаг. Үр дүнд нь: Энгийн database дээр 100GB эзлэх байсан өгөгдөл TSDB дээр ердөө 10-15GB зай эзэлж багасдаг.
Удахгүй TSDB-ууд (TimescaleDB, InfluxDB, Prometheus гэх мэт) гарч ирсэн. Эдгээр нь дараах техникийн шийдлүүдээр ялгардаг:
Compression (Шахалт): Цаг хугацааны дарааллаар ижил төстэй утгуудыг маш өндөр түвшинд шахдаг тул хадгалалтын зайг 80-90% хүртэл хэмнэдэг.
Columnar Storage: Өгөгдлийг мөрөөр бус баганаар нь хадгалж, агрегат функцуудыг (AVG, SUM, MAX) маш хурдан гүйцэтгэдэг.
Continuous Aggregates: Том хүснэгтүүдийг минут, цаг, өдрөөр автоматаар нэгтгэн урьдчилан тооцоолж хадгалдаг.
Аж үйлдвэр 4.0 (Smart Manufacturing): Үйлдвэрийн роботуудын чичирхийлэл, температурыг секунд тутам хянаж, эвдрэхээс нь өмнө урьдчилан таамаглах (Predictive Maintenance).
Эрчим хүчний сүлжээ: Ухаалаг тоолууруудын өгөгдлийг цуглуулж ачааллыг тэнцвэржүүлэх.
Микросервисийн мониторинг: Системийн CPU, RAM ашиглалтыг бодит цаг хугацаанд хянах.
IoT төхөөрөмжүүдийн тоо өсөхийн хэрээр өгөгдлийг зөвхөн хадгалах биш, харин хурдан бөгөөд үр дүнтэй шинжлэх чадвар инженерүүдийн өмнөх гол сорилт болж байна. Систем архитектур зохиохдоо өгөгдлийн шинж чанарт тохирсон өгөгдлийн сан сонгох нь ирээдүйн зардлыг хэмнэх хамгийн чухал алхам юм.