Бүх нийтлэлүүд
2026.10.023 min read#хиймэлоюунбаөгөгдлийншинжлэхухаан#MachineLearning#MFCC#SpeechRecognition#ArtificialIntelligence#AudioProcessing
Компьютер хүний дуу хоолойг яаж сонсдог вэ?
Б.Солонгоо
Багш

Б.Солонгоо
Багш
Бид өдөр бүр Siri, Google Assistant, voice search зэрэг технологийг ашиглан компьютертэй дуу хоолойгоор харилцдаг. Гэхдээ компьютер хүний хэлж буй үгийг яг хүн шиг “сонсож”, ойлгодоггүй. Компьютерийн хувьд дуу хоолой гэдэг нь микрофоноор дамжин орж ирсэн тоон өгөгдөл юм. Тэгвэл хүний ярьсан дууг Machine Learning model ойлгож болохуйц мэдээлэл болгон хэрхэн хувиргадаг вэ? Энэ асуултын хариултыг ойлгоход MFCC (Mel-Frequency Cepstral Coefficients) хэмээх feature extraction арга чухал үүрэгтэй.
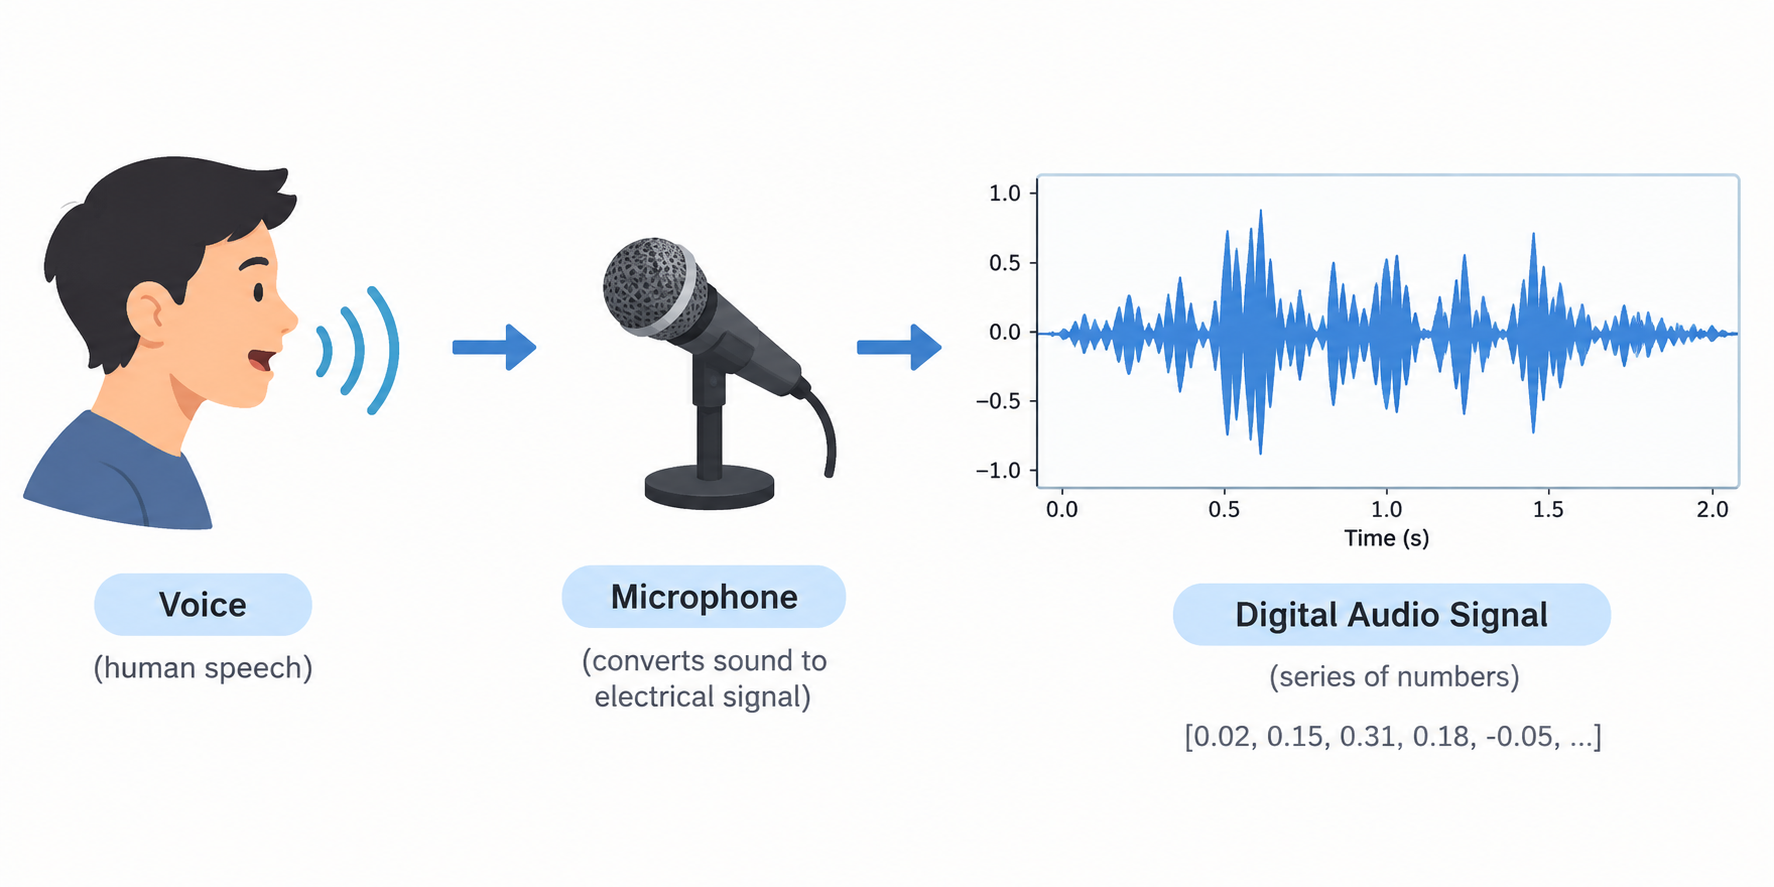
Хүн ярьж эхлэхэд хоолойноос үүссэн чичиргээ агаараар тархаж, микрофонд хүрдэг. Микрофон энэ физик чичиргээг цахилгаан дохио болгон хувиргаад, компьютер түүнийг тоон утгуудын дараалал болгон хадгална. Жишээлбэл, аудио өгөгдөл [0.02, 0.15, 0.31, 0.18, -0.05, ...] гэх мэт утгуудын дараалал хэлбэртэй байж болно. Эдгээр тоо нь тухайн агшинд дууны долгионы далайцыг илэрхийлдэг. Гэхдээ ийм түүхий аудио өгөгдлийг шууд хараад тухайн хүн ямар авиа хэлснийг тодорхойлох амаргүй. Нэг дууны хэдэн секундийн бичлэг ч маш олон тооны sample-ээс бүрдэнэ. Тиймээс аудиог шууд Machine Learning загварт өгөхийн оронд эхлээд тухайн дуу хоолойг тодорхойлоход хэрэгтэй шинжүүдийг гаргаж авдаг. Үүнийг feature extraction гэж нэрлэдэг.
MFCC нь аудионоос шууд гарч ирдэг утга биш бөгөөд хэд хэдэн боловсруулалтын дараа үүсдэг. Ерөнхийдөө аудио өгөгдөл Audio → FFT → Mel Filter Bank → Log → DCT → MFCC гэсэн дарааллаар боловсруулна.
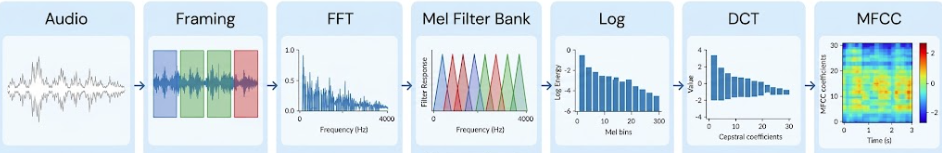
Эхлээд аудиог бүхэлд нь нэг дор боловсруулахын оронд богино хугацааны жижиг хэсгүүд буюу frame болгон хуваадаг. Учир нь хүний ярианы дууны шинж чанар хугацааны туршид байнга өөрчлөгддөг. Дараа нь Fast Fourier Transform (FFT) ашиглан аудиог time domain-оос frequency domain руу шилжүүлнэ. Өөрөөр хэлбэл waveform хэлбэрээр харагдаж байсан дохионоос ямар давтамж агуулагдаж байгааг тодорхойлно. Гэхдээ хүний чих бүх давтамжийг ижил байдлаар мэдэрдэггүй. Тиймээс frequency spectrum-ийг хүний сонсголын онцлогтой илүү ойролцоо болгохын тулд Mel scale ашигладаг. Mel filter bank нь frequency spectrum-ийг хэд хэдэн хэсэгт хувааж, тухайн хэсгүүдийн энергийг тооцно. Үүний дараа логарифм ашиглан утгуудыг шахаж, Discrete Cosine Transform (DCT) хэрэглэснээр хоорондоо хамааралтай мэдээллийг цөөн коэффициентээр төлөөлүүлдэг. Ингээд эцэст нь MFCC коэффициент гарч ирнэ.
MFCC өөрөө Machine Learning загвар биш, харин загварт өгөх feature юм. Түүхий аудиог шууд загварт өгөхийн оронд эхлээд feature extraction хийнэ. Өөрөөр хэлбэл процесс нь Raw Audio → Feature Extraction → MFCC → Machine Learning Model → Prediction гэсэн бүтэцтэй байна.
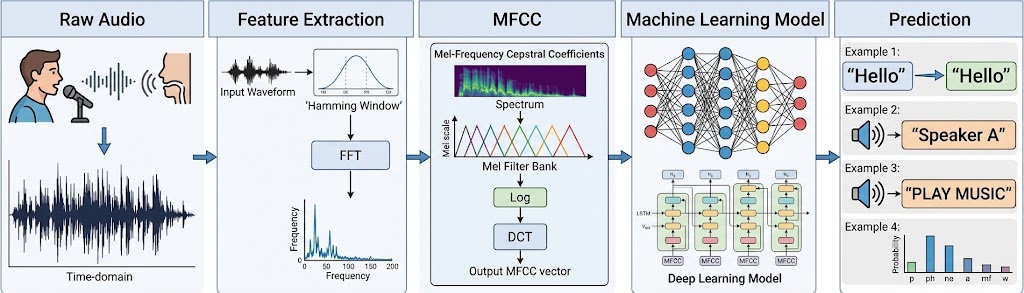
Жишээлбэл, хүн “А” авиа хэллээ гэж бодъё. Микрофон тэр авиаг бүртгэж, MFCC процессоор дамжуулан feature гаргана. Дараа нь уг feature-ийг CNN, RNN, LSTM зэрэг Machine Learning загварт өгч, загвар өмнө нь сурсан хэв шинжүүдтэй харьцуулан ямар авиа болохыг ангилна. Үр дүнд нь жишээлбэл А → 92% гэх мэт prediction гарч болно.
Эндээс бид компьютер хүний дуу хоолойг яг хүн шиг “сонсдог” биш гэдгийг ойлгож болно. Компьютер эхлээд дууны долгионыг тоон өгөгдөл болгон хувиргаж, дараа нь тухайн өгөгдлөөс давтамж болон бусад акустик шинжүүдийг гарган авдаг. MFCC зэрэг feature extraction аргууд эдгээр шинжүүдийг Machine Learning загварт тохиромжтой хэлбэрээр илэрхийлж, загвар тэдгээрээс тодорхой хэв шинжийг суралцан эцэст нь prediction гаргадаг. Тиймээс компьютерийн хувьд сонсох гэдэг нь үнэндээ дууны физик дохиог тоон өгөгдөл болгон хувиргах, түүнээс хэрэгтэй feature-үүдийг гарган авах, Machine Learning загвар ашиглан тэдгээр feature-үүдээс хэв шинжийг таних үйл явц юм.