Бүх нийтлэлүүд
2026.11.154 min read#хиймэлоюунбаөгөгдлийншинжлэхухаан#ocr#optic character recognition#ai#HCI
OCR
Н.Чигцалмаа
Багш

Н.Чигцалмаа
Багш
OCR систем нь эхлээд зураг дахь текстийн хэсгийг илрүүлж, дараа нь үсэг болон тэмдэгтийн дүрсийг шинжлэн, танигдсан мэдээллийг текст хэлбэрээр гаргах зарчимд үндэслэдэг.
Үндсэн үйл явц нь дараах дарааллаар явагдана:
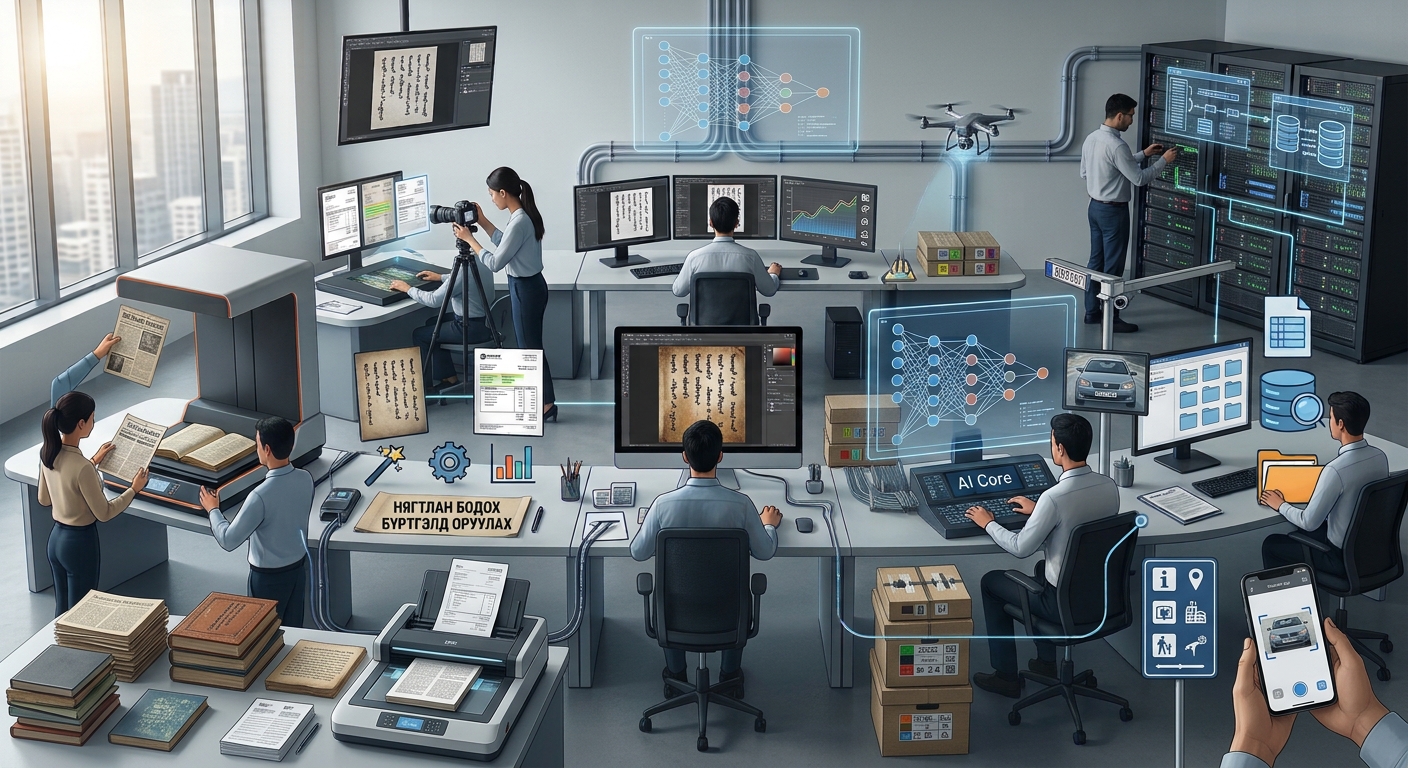
Камер эсвэл сканнераар баримт бичгийн зургийг хүлээн авна.
Зургийн чанарыг сайжруулж, шаардлагатай дүрс боловсруулалтыг хийнэ.
Зураг дахь текстийн хэсэг болон мөрүүдийг илрүүлнэ.
Үсэг, тоо болон бусад тэмдэгтийг таньж, текст болгон хувиргана.
Танигдсан текстийг боловсруулж, цахим хэлбэрээр хадгалах эсвэл бусад системд ашиглана.
Орчин үеийн OCR системүүдэд машин сургалт болон гүн сургалтын алгоритмуудыг ашигласнаар олон төрлийн фонт, баримт бичгийн бүтэц болон дүрсний нөхцөлд текст таних боломж сайжирч байна. Мөн OCR технологийг бусад программ хангамжтай нэгтгэснээр баримт бичгийн мэдээллийг автоматаар боловсруулах, хайх болон ангилах боломж бүрддэг.
Text Detection – Зураг дотор текст агуулсан хэсэг, мөр эсвэл үгийн байршлыг илрүүлэх үйл явц юм. Энэ нь текстийг зөв таних эхний шат болдог.
Character Recognition – Үсэг, тоо болон тусгай тэмдэгтийн дүрсийг таньж, тохирох тэмдэгттэй холбох үйл явц юм.
Text Recognition – Илрүүлсэн текстийн хэсгийг үг, өгүүлбэр болгон таньж, машин унших боломжтой текст хэлбэрээр гаргах үйл явц юм.
Preprocessing – Текст танихаас өмнө зургийн чанарыг сайжруулах, хазайлтыг засах, шуугиан арилгах болон тодролыг нэмэгдүүлэх зэрэг боловсруулалт юм. Энэ нь танилтын нарийвчлалыг сайжруулахад тусалдаг.
Word Error Rate (WER) – Танигдсан текст болон эх текстийн хоорондох үг нэмэгдсэн, хасагдсан эсвэл буруу танигдсан тохиолдлыг харьцуулан үнэлдэг үзүүлэлт юм. WER бага байх тусам танилтын үр дүн илүү сайн байна.
Character Error Rate (CER) – Эх текст болон танигдсан текстийн хоорондох тэмдэгтийн түвшний алдааг хэмждэг үзүүлэлт юм. Энэ нь үсэг, тоо болон тэмдэгт таних нарийвчлалыг үнэлэхэд ашиглагдана.
OCR технологийг мэдээлэл боловсруулах болон баримт бичгийн цахимжуулалт шаардлагатай олон салбарт ашиглах боломжтой.
Хэвлэмэл ном, сонин болон баримт бичгийг цахим хэлбэрт хөрвүүлэх;
Сканнердсан гэрээ, тайлан болон бусад баримтаас текст гаргаж авах;
Нэхэмжлэх, төлбөрийн баримт болон маягтаас мэдээлэл автоматаар унших;
Зураг дээрх текстийг таньж, хайлт хийх боломжтой болгох;
Номын сан, архивын материалыг цахимжуулж, мэдээллийн сан бүрдүүлэх;
Замын тэмдэг болон тээврийн хэрэгслийн улсын дугаарын тэмдэгтийг таних системд ашиглах;
Гар утасны камераар баримт бичиг болон хэвлэмэл текстийг таних;
Баримт бичгийн мэдээллийг өгөгдлийн сан болон байгууллагын мэдээллийн системд автоматаар оруулах.
Баримт бичгийг гараар шивж оруулахад зарцуулах цаг хугацааг багасгах;
Их хэмжээний текстэн мэдээллийг богино хугацаанд боловсруулах;
Цаасан баримт бичгийг цахим хэлбэрт шилжүүлэх;
Текстэн мэдээллийг хайх, засварлах болон ангилах боломж бүрдүүлэх;
Мэдээлэл боловсруулах үйл явцыг автоматжуулах;
Байгууллагын мэдээллийн сан бүрдүүлэх болон өгөгдөл боловсруулах ажлыг хөнгөвчлөх;
Архив болон хуучин баримт бичгийн мэдээллийг хүртээмжтэй болгох.
OCR технологид тодорхой хязгаарлалтууд байдаг.
Зургийн нягтаршил бага, бүдэг эсвэл шуугиантай байх үед текстийг буруу таних эрсдэлтэй;
Гэрэлтүүлгийн өөрчлөлт, сүүдэр болон баримт бичгийн хазайлт нь танилтын нарийвчлалд нөлөөлөх;
Өөр өөр фонт, гар бичмэл болон нийлмэл тэмдэгтүүдийг танихад хүндрэл үүсэх;
Хүснэгт, багана, зураг болон текст холилдсон баримт бичгийн бүтцийг зөв хадгалахад хүндрэлтэй;
Ховор хэрэглэгддэг хэл, үсэг болон тэмдэгтийн хувьд сургалтын өгөгдөл хангалтгүй байвал танилтын чанар буурах;
Танигдсан текстэд үсэг, тоо болон тэмдэгтийн алдаа гарах боломжтой тул үр дүнг шалгах шаардлагатай;
Нууц болон хувийн мэдээлэл агуулсан баримт бичгийг боловсруулахдаа мэдээллийн аюулгүй байдал, хадгалалт болон зөвшөөрлийн асуудлыг анхаарах шаардлагатай.
OCR технологи нь зураг болон баримт бичигт агуулагдах текстийг автоматаар таньж, машин унших боломжтой цахим өгөгдөл болгон хувиргах боломжийг олгодог чухал технологи юм. Компьютерын хараа, дүрс боловсруулалт болон хиймэл оюун ухааны хөгжлийн үр дүнд OCR системүүдийн текст таних чадвар сайжирч, баримт бичгийн цахимжуулалт болон мэдээлэл боловсруулах үйл явцыг автоматжуулахад өргөн ашиглагдаж байна.
Гэсэн хэдий ч зургийн чанар, бичгийн төрөл, хэлний онцлог болон баримт бичгийн бүтэц зэрэг хүчин зүйлс нь танилтын нарийвчлалд нөлөөлдөг. Иймээс найдвартай үр дүнд хүрэхийн тулд чанартай өгөгдөл, тохирох алгоритм болон танигдсан текстийг шалгах аргачлалыг хослуулах шаардлагатай. Цаашид хиймэл оюун ухаан болон хэл боловсруулах технологийн хөгжилтэй уялдан OCR нь олон хэлний мэдээллийг илүү нарийвчлалтай таних, баримт бичгийг ухаалгаар боловсруулах системүүдийн чухал бүрэлдэхүүн хэвээр байх боломжтой.