Бүх нийтлэлүүд
2026.10.172 min read#хиймэлоюунбаөгөгдлийншинжлэхухаан
TF-IDF (Term Frequency-Inverse Document Frequency)
М.Зоригт
Багш

М.Зоригт
Багш
TF-IDF (Term Frequency - Inverse Document Frequency) нь NLP-(Natural Learning Processing) болон мэдээлэл хайлтын салбарт өргөн хэрэглэгддэг статистик арга юм. Энэ аргачлал нь тухайн тодорхойлсон үг нь документэд дахь давтамж болон нийт документийн хүрээн дэхь давтамжуудыг тодорхойлдог.
Энэхүү аргачлал нь 2 үндсэн аргаар тогтоно.
1. Term Frequency- TF
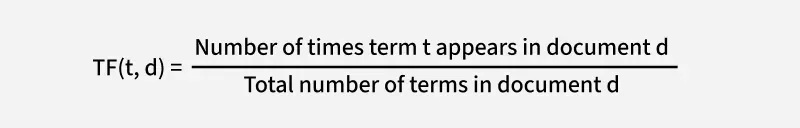
Энэхүү томьёо нь үг нь тухайн бичвэрт хэдэн удаа давтагдахыг хэмжинэ. Давтамж өндөр байх тусмаа тухайн үг чухал үүрэг гүйцэт
2. Inverse-Document-Frequency (IDF)
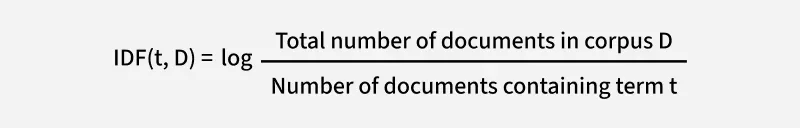
Энэхүү томьёо нь нийт байгаа бичвэрийн хүрээнд тухайн үг нь хэр их давтамжтай байхыг тодорхойлдог. IDF - ийн үр дүн нь өндөр байх тусам
Ховор үг (цөөн бичвэрт агуулагддаг) → өндөр IDF оноотой.
Түгээмэл үг (ихэнх бичвэрт байдаг, жишээ нь: "ба", "энэ", "бол") → бага IDF оноотой.
Гурван бичвэр байг:
Бичвэр 1: "Муур дэвсгэр дээр байна."
Бичвэр 2: "Нохой байшинд байна."
Бичвэр 3: "Нохой, муур хоёр найзууд."
"муур" гэдэг үгийн TF-IDF оноог тооцоолъё:
TF (Үгний давтамж) тооцоолол:
Бичвэр 1: "муур" 1 удаа, нийт 5 үг →
Бичвэр 2: "муур" байхгүй →
Бичвэр 3: "муур" 1 удаа, нийт 5 үг →
IDF (Эсрэг бичвэрийн давтамж) тооцоолол:
"муур" нь 3 бичвэрийн 2-т орсон.
IDF = log(2/3) = 0.176
TF-IDF тооцоолол:
Бичвэр 1: 1/5 * 0.176 = 0.0352
Бичвэр 2: 0*0.176 = 0
Бичвэр 3: 1/5 * 0.176 = 0.0352
Ингэснээр "муур" гэдэг үг Бичвэр 1 болон 3-д илүү ач холбогдолтой, харин Бичвэр 2-т хамааралгүй болохыг харуулж байна.
Хайлтын системүүд – Хайлтын үр дүнг эрэмбэлэх
Текстийн онцлог үгсийг тодорхойлох – Текстийн гол санааг олж илрүүлэх
Спам шүүлтүүр – Түгээмэл бус үгс дээр суурилан и-мэйлүүдийг ангилах
Машин сургалт, AI – Мэдээллийг тоон өгөгдөл болгон хувиргах
TF-IDF нь бичвэр дэх хамгийн чухал үгсийг тодорхойлох бөгөөд түгээмэл үгсийн нөлөөг бууруулдаг. Энэ аргыг хайлтын системүүд, NLP, машин су